Получил определенные результаты: БПФ 8..256 работает в gtkwave и в modelsim. Исходники на гитхаб. Получилось очень много кода, кое-что еще нужно переписать для лучшей читаемости, но оно работает. Осталось проверить непосредственно в железке. Комментировать мне лень, позже все сделаю.
среда, 20 мая 2015 г.

понедельник, 27 апреля 2015 г.
Бабочка БПФ на Verilog
Я продолжаю делить задачу расчета БПФ на части. В наличии уже есть сдвиговый регистр, внутри которого реализовано умножение на оконную функцию. Теперь реализуем бабочку БПФ. Смысл очень прост: бабочка БПФ это есть ДПФ, по скольку основание БПФ кратно степени 2, то БПФ можно разбить на ДПФ (бабочки) по основанию 2 и затем объединить их.
ДПФ2 на pyhon:
ДПФ2 на pyhon:
    def FSM_BF2(self, i_clk, i_en, o_rd_addr, i_data, o_we, o_data, o_wr_addr, FFT_SIZE):
        LEN = len(i_data)
        MY_LEN = LEN/2
        WIDTH = MY_LEN - 1
        WIDTH_SUM = WIDTH + 1

        r_rd_addr = [Signal(modbv(0,0,FFT_SIZE)) for i in range(2)]
        r_wr_addr = Signal(modbv(0,0,FFT_SIZE))

        #r_addr = Signal(modbv(0,0,DEPTH))
        r_we = [Signal(bool(0)) for i in range(3)]
        r_data = Signal(intbv(0,-2**WIDTH, 2**WIDTH))
        r_in_data = Signal(intbv(0,-2**WIDTH, 2**WIDTH))
        r_out_data = [Signal(intbv(0,-2**WIDTH, 2**WIDTH)) for i in range(2)]

        w_sum = Signal(intbv(0, -2**WIDTH_SUM, 2**WIDTH_SUM))
        w_sub = Signal(intbv(0, -2**WIDTH_SUM, 2**WIDTH_SUM))
        @always_comb
        def f_sum():
            w_sum.next = r_in_data + i_data[LEN:MY_LEN].signed()
        @always_comb
        def f_sub():
            w_sub.next = r_in_data - i_data[LEN:MY_LEN].signed()

        @always_comb
        def f_data():
            o_data.next = r_out_data[r_wr_addr[0]]
        @always_comb
        def f_rd_addr():
            o_rd_addr.next = r_rd_addr[0]
        @always_comb
        def f_wr_addr():
            o_wr_addr.next = r_wr_addr
        @always_comb
        def f_we():
            o_we.next = r_we[0]


        @always(i_clk.posedge)
        def seq():
            if i_en == 1:
                r_rd_addr[1].next = r_rd_addr[0]
                if r_rd_addr[0] != FFT_SIZE - 1:
                    r_rd_addr[0].next = r_rd_addr[0] + 1
#                if r_rd_addr[0] != r_rd_addr[0].max-1:
#                    r_rd_addr[0].next = r_rd_addr[0] + 1
#
                if r_rd_addr[1] == 1:
                    r_we[0].next = 1
                if r_wr_addr == r_wr_addr.max - 1:
                    r_we[0].next = 0
#
                if r_we[0] == 1:
                    r_wr_addr.next = r_wr_addr + 1

                if r_rd_addr[1][0]  == 0:
                    r_in_data.next = i_data[LEN:MY_LEN].signed()
                else:
                    r_out_data[0].next = w_sum[:1].signed()
                    r_out_data[1].next = w_sub[:1].signed()
            else:
                r_rd_addr[0].next = 0
                r_rd_addr[1].next = 0
                r_out_data[0].next = 0
                r_out_data[1].next = 0
                r_we[0].next = 0
                r_we[1].next = 0
        return  f_sum, f_sub, f_data, f_rd_addr, f_wr_addr, f_we, seq
Поехали сверху вниз:
i_clk - тактовый вход
i_en - в данном случае выполняет функцию синхронного сброса
o_rd_addr - адрес чтения из памяти
i_data - вход данных (берутся из памяти)
o_data - выходные данные (пишутся в память)
o_we - выход разрешения записи в память
o_wr_addr - адрес записи в память
FFT_SIZE - константа не используется
константы:
LEN - длины входных данных, вида {RE,IM}. В моем случае 32 бита
MY_LEN - длина RE, 16 бит
WIDTH - количество бит для знакового представления числа
WIDTH_SUM - количество бит для представления суммы 2 знаковых чисел
Тут стоить сказать о нюансах. Если посчитать ДПФ8 от синусоиды с амплитудой 1, то мы получим 8. Если ДПФ16 - 16. То есть в зависимости от основания ДПФ меняется его результат. Чтобы результаты не менялись я буду делить на 2 результаты после каждой стадии, что аналогично умножению на 1/N в формуле ДПФ.
r_rd_addr[][2] - регистр адреса чтения из памяти (2 переменных). Первый регистр используется, чтобы выставить адрес на линии для ram, второй регистр (на один такт задержанный первый) используется, чтобы правильно интерпретировать входные данные.
r_wr_addr - регистр адреса записи
r_we[2] - регистр записи в память. Второй бит не используется
r_in_data - регистр входных данных
r_out_data[][2] - выход бабочки по основанию 2
w_sum, w_sub - комбинаторные выходы бабочки
Дальше требует пояснения строка 27: r_out_data[r_wr_addr[0]]. Есть два регистра r_out_data[], мультиплексором управляет нулевой бит r_wr_addr.
[LEN:MY_LEN] в строках 20,23, 57 вытаскивает из входных данных RE
Порт на verilog:
assign fsm_bf2_w_sum = (fsm_bf2_r_in_data + $signed(o_w_dualram_data[32-1:16]));


assign fsm_bf2_w_sub = (fsm_bf2_r_in_data - $signed(o_w_dualram_data[32-1:16]));


assign o_w_bf2_data = fsm_bf2_r_out_data[fsm_bf2_r_wr_addr[0]];


assign o_w_bf2_rd_addr = fsm_bf2_r_rd_addr[0];


assign o_w_bf2_wr_addr = fsm_bf2_r_wr_addr;


assign o_w_bf2_we = fsm_bf2_r_we[0];


always @(posedge i_clk) begin: FFT_FSM_FSM_BF2_SEQ
    if ((r_en_bf2 == 1)) begin
        fsm_bf2_r_rd_addr[1] <= fsm_bf2_r_rd_addr[0];
        if (($signed({1'b0, fsm_bf2_r_rd_addr[0]}) != (16 - 1))) begin
            fsm_bf2_r_rd_addr[0] <= (fsm_bf2_r_rd_addr[0] + 1);
        end
        if ((fsm_bf2_r_rd_addr[1] == 1)) begin
            fsm_bf2_r_we[0] <= 1;
        end
        if (($signed({1'b0, fsm_bf2_r_wr_addr}) == (16 - 1))) begin
            fsm_bf2_r_we[0] <= 0;
        end
        if ((fsm_bf2_r_we[0] == 1)) begin
            fsm_bf2_r_wr_addr <= (fsm_bf2_r_wr_addr + 1);
        end
        if ((fsm_bf2_r_rd_addr[1][0] == 0)) begin
            fsm_bf2_r_in_data <= $signed(o_w_dualram_data[32-1:16]);
        end
        else begin
            fsm_bf2_r_out_data[0] <= $signed(fsm_bf2_w_sum[17-1:1]);
            fsm_bf2_r_out_data[1] <= $signed(fsm_bf2_w_sub[17-1:1]);
        end
    end
    else begin
        fsm_bf2_r_rd_addr[0] <= 0;
        fsm_bf2_r_rd_addr[1] <= 0;
        fsm_bf2_r_out_data[0] <= 0;
        fsm_bf2_r_out_data[1] <= 0;
        fsm_bf2_r_we[0] <= 0;
        fsm_bf2_r_we[1] <= 0;
    end
end
понедельник, 30 марта 2015 г.
Сдвиговый регистр на RAM в MyHDL
В определенный момент, например при фильтрации, может понадобиться очень большой буфер для хранения отсчетов сигнала, который будет невозможно реализовать за счет регистров. Здесь нам на помощь приходит внутренняя память (RAM) ПЛИС, которую можно превратить в сдвиговый регистр, реализовав модуль обертку над ней.
Писать будем на Python с помощью MyHDL. Начну немного с того: с реализации ROM:
Поставим за правило: все необходимые параметры модуля выдергивать из входных данных. Например, если входной адрес состоит из 2 бит, то максимально можно адресовать 4 слова. Другой вариант применительно для ROM: начальная инициализация памяти массивом. По факту из примера можно выкинуть 2 и 3 строчки - ничего бы не изменилось. Теперь про RAM:
Здесь описана dual port память. В общем случае, наверно, разрядность адресов на двух портах может быть разной. Поэтому глубина памяти (количество ячеек) считается исходя из "худшего" случая. Разрядность данных такая, потому что они считаются знаковыми. На четвертой строчке инициализируем память нулями и на пятой строчке объявляем выходной регистр. Двух портовая память потому что нужно по одному адресу читать и писать в определенное время (так можно сделать и с обычной памятью, но я не стал пробовать). Дальше все в принципе понятно, если нет, то разобраться можно, прочтя страницу проекта MyHDL.
Теперь поехали дальше: сдвиговый регистр или обертка над RAM. Сразу пример кода чего хотим:
Тут вся магия в мультиплексоре на строках 30-34. Фактически w_din обратная связь, которая идет на выход и на вход RAM. Эта обертка сдвигает адреса и ставит запись так, чтобы первый отсчет в один такт помещался в выходной регистр и в память записывалось новое значение на входе, а на следующем такте старое значение переписывалось в ячейку с увеличенным на единицу адресом и так до конца. Теперь можно легко реализовать фильтр как в прошлой статье, используя сдвиговый регистр и ROM с коэффициентами фильтра + добавить умножение с накоплением. Я же в качестве еще одного примера покажу процедуру умножения сдвигового регистра на оконную функцию для БПФ. Благодаря такому ходу можно разделить задачу подготовки данных для БПФ, алгоритм или конечный автомат его подсчета и подготовку данных на выкачку.
Дальше будем разбираться с конечными автоматами на MyHDL
Писать будем на Python с помощью MyHDL. Начну немного с того: с реализации ROM:
    def ROM(self, i_clk, i_rst, i_en, i_read_adr, o_data, CONTENT):
        DEPTH = len(CONTENT)
        WIDTH = len(o_data) - 1
        @always_comb
        def comb():
            o_data.next = CONTENT[i_read_adr]
        return comb#, seq
Поставим за правило: все необходимые параметры модуля выдергивать из входных данных. Например, если входной адрес состоит из 2 бит, то максимально можно адресовать 4 слова. Другой вариант применительно для ROM: начальная инициализация памяти массивом. По факту из примера можно выкинуть 2 и 3 строчки - ничего бы не изменилось. Теперь про RAM:
    def RAM(self, i_clk, i_rst, i_en, i_read_adr, i_write_adr, i_we, i_data, o_data):
        DEPTH = max(2**len(i_read_adr), 2**len(i_write_adr))
        WIDTH = len(i_data) - 1
        mem = [Signal(intbv(0, -2**WIDTH, 2**WIDTH)) for i in range(DEPTH)]
        r_dout = Signal(intbv(0, -2**WIDTH, 2**WIDTH))
        @always_comb
        def exits():
            o_data.next = r_dout
        @always(i_clk.posedge, i_rst.negedge)
        def seq():
            if i_rst == 0:
                r_dout.next = 0
            elif i_en == 1:
                r_dout.next = mem[i_read_adr]
                if i_we == 1:
                    mem[i_write_adr].next = i_data
        return exits, seq
Здесь описана dual port память. В общем случае, наверно, разрядность адресов на двух портах может быть разной. Поэтому глубина памяти (количество ячеек) считается исходя из "худшего" случая. Разрядность данных такая, потому что они считаются знаковыми. На четвертой строчке инициализируем память нулями и на пятой строчке объявляем выходной регистр. Двух портовая память потому что нужно по одному адресу читать и писать в определенное время (так можно сделать и с обычной памятью, но я не стал пробовать). Дальше все в принципе понятно, если нет, то разобраться можно, прочтя страницу проекта MyHDL.
Теперь поехали дальше: сдвиговый регистр или обертка над RAM. Сразу пример кода чего хотим:
    def Shift_reg(self, i_clk, i_rst, i_en, i_new_data, i_din, o_active, o_dout, o_addr, DEPTH):
        WIDTH = len(i_din) - 1
        w_din = Signal(intbv(0, -2**WIDTH, 2**WIDTH))
        w_dout = Signal(intbv(0, -2**WIDTH, 2**WIDTH))
        ###
        FFT_len = DEPTH
        ###
        n = int(np.log2(FFT_len))
        r_addr = Signal(intbv(0,0,2**n))
        r_we = Signal(bool(0))

        ram = self.RAM(i_clk, i_rst, i_en, r_addr, r_addr, r_we, w_din, w_dout)
        @always(i_clk.posedge, i_rst.negedge)
        def seq():
            if not i_rst:
                r_we.next = 0
                r_addr.next = 0
            elif i_en:
                if i_new_data:
                    r_we.next = 1
                    r_addr.next = 0
                else:
                    if r_addr != r_addr.max - 1:
                        r_addr.next = r_addr + 1
                        r_we.next = 1
                    else:
                        r_we.next = 0

        @always_comb
        def comb():
            if r_addr == 0:
                w_din.next = i_din
            else:
                w_din.next = w_dout
        @always_comb
        def dout():
            o_dout.next = w_din
        @always_comb
        def active():
            o_active.next = r_we
        @always_comb
        def addr():
            o_addr.next = r_addr
        return ram, seq, comb, dout, active,addr
    def FFT_input(self, i_clk, i_rst, i_en, i_new_data, i_din, o_dout, o_active_write, o_addr, FFT_SIZE):
        WIDTH = len(i_din) - 1
        WINDOW_WIDTH = WIDTH - 1
        DEPTH = FFT_SIZE
        wo_union = Signal(bool(0))
        wo_shift_data = Signal(intbv(0,-2**WIDTH, 2**WIDTH))
        w_dout = Signal(intbv(0,-2**WIDTH, 2**WIDTH))
        wo_addr = Signal(intbv(0,0,FFT_SIZE))

        shift = self.Shift_reg(i_clk, i_rst, i_en, i_new_data, i_din, wo_union, wo_shift_data, wo_addr,FFT_SIZE)

        wo_window = Signal(intbv(0,-2**WIDTH, 2**WIDTH))
        W_blackman = np.blackman(DEPTH)
        W_blackman = W_blackman / max(W_blackman)
        CONTENT = tuple([int(W_blackman[i]*(2**WINDOW_WIDTH)) for i in range(DEPTH)])
        print CONTENT
        rom = self.ROM(i_clk, i_rst, i_en, wo_addr, wo_window, CONTENT)
        MULT_WIDTH = 2*len(i_din) - 1
        w_mult = Signal(intbv(0,-2**MULT_WIDTH, 2**MULT_WIDTH))
#        SHIFT_VAL = np.log2(max(CONTENT))
#        print SHIFT_VAL

        @always_comb
        def fmult():
            w_mult.next = (wo_shift_data*wo_window)# >> (WIDTH-1)
        @always_comb
        def fw_dout():
            w_dout.next = w_mult[len(i_din)+WINDOW_WIDTH:WINDOW_WIDTH]
        @always_comb
        def fo_dout():
            o_dout.next = w_dout
        @always_comb
        def fo_active_write():
            o_active_write.next = wo_union
        @always_comb
        def fo_addr():
            o_addr.next = wo_addr

        return shift, rom, fmult, fw_dout, fo_dout, fo_active_write, fo_addr
вторник, 17 марта 2015 г.
MyHDL и Scipy FIR
Еще один пример использования MyHDL в Python - реализация фильтра нижних частот. Пример кода:
Полученные коэффициенты фильтра:
 И картинка для привлечения внимания: входной сигнал, спектр входного сигнала, выходной сигнал, спектр выходного сигнала

from random import randint
import numpy as np
from myhdl import *
import matplotlib.pyplot as plt

class Cook_book():
    def PMC_sum_arg(self, i_arg1, i_arg2):
        o_len = 1 + max(len(i_arg1),len(i_arg2))
        o_len_signed = o_len-1
        return Signal(intbv(0,-2**o_len_signed, 2**o_len_signed))
    def PMC_mult_arg(self, i_arg1, i_arg2):
        o_len = len(i_arg1) + len(i_arg2)
        o_len_signed = o_len-1
        return Signal(intbv(0,-2**o_len_signed, 2**o_len_signed))

    def PMC_sum(self, i_arg1, i_arg2, o_out):
        w_out = self.PMC_sum_arg(i_arg1, i_arg2)
        @always_comb
        def exits():
            o_out.next = w_out
        @always_comb
        def comb():
            w_out.next = i_arg1 + i_arg2
        return exits, comb
####w_out
    def PMC_mult(self, i_arg1, i_arg2, o_out):
        w_out = self.PMC_mult_arg(i_arg1, i_arg2)
        @always_comb
        def exits():
            o_out.next = w_out
        @always_comb
        def comb():
            w_out.next = i_arg1*i_arg2
        return exits, comb
    def arg_ROM(self, i_adr, CONTENT):
        len_content = len(CONTENT)
        len_adr = 2**(len(i_adr))
        max_width = 0
        if len_content > len_adr:
            print "arg_ROM WARNING len_content > len_adr"
        else:
            for i in range(len(CONTENT)):
                if CONTENT[i].bit_length() > max_width:
                    max_width = CONTENT[i].bit_length()
        return Signal(intbv(0, -2**max_width, 2**max_width))

    def ROM(self, i_clk, i_adr, o_out, CONTENT):
        w_out = self.arg_ROM(i_adr, CONTENT)
        @always_comb
        def exits():
            o_out.next = w_out
        @always_comb
        def comb():
            w_out.next = CONTENT[int(i_adr)]
        return exits, comb
    def shift_arg(self, WIDTH, LEN):
        w_signed = WIDTH-1
        return [Signal(intbv(0,-2**w_signed, 2**w_signed)) for i in range(LEN)]

    def shift_reg(self, i_clk, i_rst, i_en, i_din, o_dout, WIDTH, LEN):
        w_signed = WIDTH-1
        #o_dout = self.shift_arg(WIDTH, LEN)
        r_shift = [Signal(intbv(0,-2**w_signed, 2**w_signed)) for i in range(LEN)]
        @always_comb
        def exits():
            for i in range(LEN):
                o_dout[i].next = r_shift[i]
        @always(i_clk.posedge, i_rst.negedge)
        def seq():
            if i_rst == 0:
                for i in range(LEN):
                    r_shift[i].next = 0
            elif i_en == 1:
                r_shift[0].next = i_din
                for i in range(1, LEN):
                    r_shift[i].next = r_shift[i-1]
        return exits, seq
    def serial_filter(self, i_clk, i_rst, i_newdata, i_din, o_dout, COEFFS, WIDTH, LEN):

        o_out_shift = self.shift_arg(16, len(COEFFS))
        uut_shift = self.shift_reg(i_clk, i_rst, i_newdata, i_din, o_out_shift, 16, LEN)

        MULT_MSB = 16+16
        MULT_WIDTH_SIGNED = 16+16-1
        w_mult = [Signal(intbv(0,-2**MULT_WIDTH_SIGNED, 2**MULT_WIDTH_SIGNED)) for i in range(LEN)]

        SUM_MSB = MULT_MSB + int(np.log2(LEN))
        SUM_WIDTH_SIGNED = MULT_WIDTH_SIGNED + int(np.log2(LEN))
        w_sum = Signal(intbv(0, -2**SUM_WIDTH_SIGNED, 2**SUM_WIDTH_SIGNED))

        @always_comb
        def comb_mult():
            for i in range(LEN):
                w_mult[i].next = o_out_shift[i] * COEFFS[i]
        @always_comb
        def comb_sum():
            w_sum.next = sum(w_mult)

        @always_comb
        def exits():
            o_dout.next = w_sum[SUM_MSB:SUM_MSB-16].signed()
        return uut_shift, comb_mult, comb_sum, exits

from scipy import signal

input_data = []
output_data = []
S_r = 16000.0
Nyq = S_r / 2
Cutoff = 2000.0
clk_rate = 16000.0*16

prescaller = int(clk_rate / S_r)


def tb():
    global input_data
    global output_data
    global S_r
    global Nyq
    global Cutoff
    global precaller


    clk = Signal(bool(0))
    i_en = Signal(bool(0))
    i_rst = Signal(bool(0))
    @instance
    def clk_gen():
        while True:
            yield delay(1)
            clk.next = not clk

    defines = Cook_book()

    N = 4
    N_signed = N - 1
    i_adr = Signal(modbv( 0, 0, 2**N))

    n = 2**len(i_adr)
    print n
    a = signal.firwin(n, cutoff = 0.1, window = "hamming")
    fir_coeffs = signal.firwin(n, Cutoff/Nyq)

    M = 16-1
    CONTENT = [int((-1+2**M)*fir_coeffs[i]) for i in range(n)]
    plt.plot(CONTENT, 'r')
    print CONTENT
    i_din = Signal(intbv(0, -2**M, 2**M))
    o_dout = Signal(intbv(0, -2**M, 2**M))
    uut = defines.serial_filter(clk, i_rst, i_en, i_din, o_dout, CONTENT, 16, len(CONTENT))
    cnt = Signal(intbv(0,0,16))
    @instance
    def control():
        #global prescaller
        yield clk.posedge
        i_rst.next = 1
        yield clk.posedge
        yield clk.posedge
        yield clk.posedge
        i_en.next = 1
        while True:

            yield clk.posedge
            cnt.next = (cnt + 1 ) %16
            if cnt.next == 0:
                i_en.next = 1
            else:
                i_en.next = 0


    @always(clk.posedge)
    def monitor():
        if i_en == 1:
            tmp = randint(1-2**15, -1+2**15)
            input_data.append(tmp)
            output_data.append(int(o_dout))
            i_din.next = tmp
            i_adr.next = i_adr + 1
    return clk_gen, monitor, uut, control

inst = traceSignals(tb)
sim = Simulation(inst)
sim.run(2000)

fig, ax = plt.subplots(4,1)
ax[0].plot(input_data)
X_in = np.fft.fft(input_data)
X_in = abs(X_in) / max(abs(X_in))
X_in_db = 20*np.log10(X_in)
ax[1].plot(X_in_db)
ax[2].plot(output_data)
print output_data
X_out = np.fft.fft(output_data)
X_out = abs(X_out) / max(abs(X_out))
X_out_db = 20*np.log10(X_out)
ax[3].plot(X_out_db)
вторник, 10 марта 2015 г.
MyHDL и CORDIC
MyHDL реализация для CORDIC на гитхаб. Плюсами данной реализации можно считать автоматизацию процесса расчета необходимых параметров для алгоритма, таких как углы, усиление, нужное количество итераций.
Из очевидных плюсов MyHDL - можно строить графики в python используя данные из тестбенча. Например:
 Тут посчитан спектр в дБ для одной из квадратур. Для этого необходимо всего лишь запустить симуляцию testbench на 10000 итераций
И посчитать БПФ
Чтобы получить .v файлы нужно воспользоваться этой частью:
И тогда получившийся файл:
Из очевидных плюсов MyHDL - можно строить графики в python используя данные из тестбенча. Например:
N = 16
f = 500
F = 8000
inst = traceSignals(tb, N, f, F)
sim = Simulation(inst)
sim.run(10000)
И посчитать БПФ
N_FFT = 128
fig, ax = plt.subplots(3,1)
ax[0].plot(plt_clk[-1-N_FFT:-1:1],'ro-')
ax[1].plot(plt_cnt[-1-N_FFT:-1:1],'bo-')

N_FFT = 4096
freq = [float(i)*F/N_FFT for i in range(N_FFT)]
X = np.fft.fft(plt_cnt[-1-N_FFT:-1:1]) + float(N_FFT)/1000
mags = abs(X) / max(abs(X))
X_db = 20*np.log10(mags)
ax[2].plot(freq, X_db)
fig.tight_layout()
Чтобы получить .v файлы нужно воспользоваться этой частью:
n = 16
n_signed = n - 1
i_clk = Signal(bool(0))
i_rst = Signal(bool(0))
i_en = Signal(bool(0))
o_Re = Signal(intbv(0, -2**n_signed, 2**n_signed))
o_Im = Signal(intbv(0, -2**n_signed, 2**n_signed))
f = 2000
F = 8000
freq = Signal(intbv(f,0,2**f.bit_length()))
discr_freq = Signal(intbv(F, 0, 2**F.bit_length()))
uut = toVerilog(Cordic_generator, i_clk, i_rst, i_en, freq, discr_freq, o_Re, o_Im, n)
И тогда получившийся файл:
// File: top.v
// Generated by MyHDL 0.8.1
// Date: Sun Mar  8 17:55:47 2015


`timescale 1ns/10ps

module top (
    i_clk,
    i_rst,
    i_en,
    i_freq,
    i_discr_freq,
    o_Re,
    o_Im
);


input i_clk;
input i_rst;
input i_en;
input [10:0] i_freq;
input [12:0] i_discr_freq;
output signed [15:0] o_Re;
wire signed [15:0] o_Re;
output signed [15:0] o_Im;
wire signed [15:0] o_Im;

wire [15:0] w_rem_next;
wire [14:0] o_reminder;
reg [14:0] r_quo;
wire [29:0] DIVIDENT;
wire [14:0] o_quotient;
wire [14:0] DISCR_FREQ;
reg [14:0] r_rem;
reg [15:0] w_quo_next;
reg [4:0] uut_0_r_cnt;
wire signed [60:0] uut_0_w_dif;
reg [59:0] uut_0_r_divider_copy;
reg [29:0] uut_0_r_quotient;
reg [59:0] uut_0_r_reminder;
reg [29:0] uut_0_r_quotient_out;
reg [29:0] uut_0_r_reminder_out;

reg [1:0] uut_1_r_quad [0:14-1];
reg signed [14:0] uut_1_angle [0:14-1];
reg signed [16:0] uut_1_w_Re [0:14-1];
reg signed [15:0] uut_1_r_Re [0:15-1];
reg signed [15:0] uut_1_r_Im [0:15-1];
reg signed [16:0] uut_1_w_Im [0:14-1];
reg signed [14:0] uut_1_r_input_arg [0:15-1];
reg signed [14:0] uut_1_r_output_arg [0:14-1];


assign DIVIDENT = (i_freq << 15);
assign DISCR_FREQ = i_discr_freq;
assign w_rem_next = (r_rem + o_reminder);


always @(w_rem_next, DISCR_FREQ, r_quo, o_quotient) begin: TOP_COMB2
    if ((w_rem_next >= DISCR_FREQ)) begin
        w_quo_next = ((r_quo + o_quotient) + 1);
    end
    else begin
        w_quo_next = (r_quo + o_quotient);
    end
end


always @(posedge i_clk) begin: TOP_SEQ
    if ((w_rem_next >= DISCR_FREQ)) begin
        r_rem <= (w_rem_next - DISCR_FREQ);
        if ((w_quo_next[(15 + 1)-1:15] == 1)) begin
            r_quo <= (w_quo_next - (2 ** 15));
        end
        else begin
            r_quo <= w_quo_next;
        end
    end
    else begin
        r_rem <= w_rem_next;
        if ((w_quo_next[(15 + 1)-1:15] == 1)) begin
            r_quo <= (w_quo_next - (2 ** 15));
        end
        else begin
            r_quo <= w_quo_next;
        end
    end
end


assign uut_0_w_dif = (uut_0_r_reminder - (uut_0_r_divider_copy >>> uut_0_r_cnt));
assign o_quotient = uut_0_r_quotient_out;
assign o_reminder = uut_0_r_reminder_out;


always @(posedge i_clk, negedge i_rst) begin: TOP_UUT_0_SEQ
    if ((i_rst == 0)) begin
        uut_0_r_cnt <= 0;
        uut_0_r_quotient <= 0;
        uut_0_r_reminder <= 0;
        uut_0_r_divider_copy <= 0;
        uut_0_r_quotient_out <= 0;
        uut_0_r_reminder_out <= 0;
    end
    else if ((i_en == 1)) begin
        uut_0_r_cnt <= ((uut_0_r_cnt + 1) % 30);
        if ((uut_0_r_cnt == 0)) begin
            uut_0_r_quotient <= 0;
            uut_0_r_reminder <= DIVIDENT;
            uut_0_r_divider_copy <= ($signed({1'b0, i_discr_freq}) << (30 - 1));
            uut_0_r_quotient_out <= uut_0_r_quotient;
            uut_0_r_reminder_out <= uut_0_r_reminder[30-1:0];
        end
        else begin
            if ((uut_0_w_dif >= 0)) begin
                uut_0_r_quotient <= ((uut_0_r_quotient << 1) + 1);
                uut_0_r_reminder <= uut_0_w_dif;
            end
            else begin
                uut_0_r_quotient <= (uut_0_r_quotient << 1);
            end
        end
    end
end


always @(uut_1_r_Re[0], uut_1_r_Re[1], uut_1_r_Re[2], uut_1_r_Re[3], uut_1_r_Re[4], uut_1_r_Re[5], uut_1_r_Re[6], uut_1_r_Re[7], uut_1_r_Re[8], uut_1_r_Re[9], uut_1_r_Re[10], uut_1_r_Re[11], uut_1_r_Re[12], uut_1_r_Re[13], uut_1_r_Re[14], uut_1_r_Im[0], uut_1_r_Im[1], uut_1_r_Im[2], uut_1_r_Im[3], uut_1_r_Im[4], uut_1_r_Im[5], uut_1_r_Im[6], uut_1_r_Im[7], uut_1_r_Im[8], uut_1_r_Im[9], uut_1_r_Im[10], uut_1_r_Im[11], uut_1_r_Im[12], uut_1_r_Im[13], uut_1_r_Im[14]) begin: TOP_UUT_1_COMB
    integer i;
    for (i=1; i<14; i=i+1) begin
        uut_1_w_Re[i] = $signed((uut_1_r_Re[(i - 1)] + (1 << (i - 1))) >>> i);
        uut_1_w_Im[i] = $signed((uut_1_r_Im[(i - 1)] + (1 << (i - 1))) >>> i);
    end
end


always @(posedge i_clk, negedge i_rst) begin: TOP_UUT_1_SEQ
    integer i;
    if ((i_rst == 0)) begin
        for (i=0; i<14; i=i+1) begin
            uut_1_r_input_arg[i] <= 0;
            uut_1_r_output_arg[i] <= 0;
            uut_1_r_quad[i] <= 0;
            uut_1_r_Re[i] <= 0;
            uut_1_r_Im[i] <= 0;
            case (i)
                0: uut_1_angle[i] <= 4096;
                1: uut_1_angle[i] <= 2418;
                2: uut_1_angle[i] <= 1278;
                3: uut_1_angle[i] <= 649;
                4: uut_1_angle[i] <= 326;
                5: uut_1_angle[i] <= 163;
                6: uut_1_angle[i] <= 81;
                7: uut_1_angle[i] <= 41;
                8: uut_1_angle[i] <= 20;
                9: uut_1_angle[i] <= 10;
                10: uut_1_angle[i] <= 5;
                11: uut_1_angle[i] <= 3;
                12: uut_1_angle[i] <= 1;
                default: uut_1_angle[i] <= 1;
            endcase
        end
    end
    else begin
        if ((i_en == 1)) begin
            uut_1_r_input_arg[0] <= r_quo[(15 - 2)-1:0];
            uut_1_r_output_arg[0] <= uut_1_angle[0];
            uut_1_r_quad[0] <= r_quo[15-1:(15 - 2)];
            uut_1_r_Re[0] <= 19897;
            uut_1_r_Im[0] <= 19897;
            for (i=1; i<14; i=i+1) begin
                uut_1_r_input_arg[i] <= uut_1_r_input_arg[(i - 1)];
                uut_1_r_quad[i] <= uut_1_r_quad[(i - 1)];
                if ((uut_1_r_output_arg[(i - 1)] > uut_1_r_input_arg[(i - 1)])) begin
                    uut_1_r_Re[i] <= (uut_1_r_Re[(i - 1)] + uut_1_w_Im[i]);
                    uut_1_r_Im[i] <= (uut_1_r_Im[(i - 1)] - uut_1_w_Re[i]);
                    uut_1_r_output_arg[i] <= (uut_1_r_output_arg[(i - 1)] - uut_1_angle[i]);
                end
                else begin
                    uut_1_r_Re[i] <= (uut_1_r_Re[(i - 1)] - uut_1_w_Im[i]);
                    uut_1_r_Im[i] <= (uut_1_r_Im[(i - 1)] + uut_1_w_Re[i]);
                    uut_1_r_output_arg[i] <= (uut_1_r_output_arg[(i - 1)] + uut_1_angle[i]);
                end
            end
            if ((uut_1_r_quad[(14 - 1)] == 0)) begin
                uut_1_r_Re[14] <= uut_1_r_Re[(14 - 1)];
                uut_1_r_Im[14] <= uut_1_r_Im[(14 - 1)];
            end
            else if ((uut_1_r_quad[(14 - 1)] == 1)) begin
                uut_1_r_Re[14] <= (-uut_1_r_Im[(14 - 1)]);
                uut_1_r_Im[14] <= uut_1_r_Re[(14 - 1)];
            end
            else if ((uut_1_r_quad[(14 - 1)] == 2)) begin
                uut_1_r_Re[14] <= (-uut_1_r_Re[(14 - 1)]);
                uut_1_r_Im[14] <= (-uut_1_r_Im[(14 - 1)]);
            end
            else if ((uut_1_r_quad[(14 - 1)] == 3)) begin
                uut_1_r_Re[14] <= uut_1_r_Im[(14 - 1)];
                uut_1_r_Im[14] <= (-uut_1_r_Re[(14 - 1)]);
            end
        end
    end
end


assign o_Re = uut_1_r_Re[14];
assign o_Im = uut_1_r_Im[14];

endmodule
пятница, 27 февраля 2015 г.
Python для ПЛИС
В предыдущим посте я упоминал про MyHDL, теперь буду разбираться с этой темой. Библиотека предоставляет псевдоверилоговский синтаксис для Python, благодаря которому можно транслировать написанные блоки на Verilog/VHDL и/или моделировать их, используя встроенные в Python средства(matplotlib) и/или создавать временные диаграммы. Возможностей на самом деле больше, но надо разбираться.
Перед тем, как погружаться в MyHDL, коротко моя сборка Python. Я пользуюсь miniconda 2.7 с установленными из репозитория пакетами numpy, matplotlib, pip (-через cmd в папке /Scrips conda install), установленным через pip spyder(-там же pip install) и скаченным c github myhdl (-cmd > python setup.py install в распакованной папке). Вот необходимый минимум.
На сайте MyHDL много описания и примеров. Моей конечной целью будет переписать CORDIC (снова, опять). Забавное совпадение, что в примерах для MyHDL есть CORDIC. Как раз посмотрю есть ли у меня где-нибудь недочеты.
Единственное новое с чем я столкнулся - декораторы и генераторы в Python. Про декораторы хорошо расписано на хабре, а генераторы по любой ссылке в гугле. Я опущу примеры с сайта MyHDL и начну с "хвоста", то есть в тестбенча.
Получившиеся графики в Pthon:
 Так же в рабочей папке появится файл .vcd, который можно открыть в gtkwave:

Видно, что результат получился одинаковым, но открывать .vcd файл дольше. В ModelSim тоже можно отрыть .vcd, но сначала нужно сконвертировать vcd2wlf в окне команд ModelSim'а.
Перед тем, как погружаться в MyHDL, коротко моя сборка Python. Я пользуюсь miniconda 2.7 с установленными из репозитория пакетами numpy, matplotlib, pip (-через cmd в папке /Scrips conda install), установленным через pip spyder(-там же pip install) и скаченным c github myhdl (-cmd > python setup.py install в распакованной папке). Вот необходимый минимум.
На сайте MyHDL много описания и примеров. Моей конечной целью будет переписать CORDIC (снова, опять). Забавное совпадение, что в примерах для MyHDL есть CORDIC. Как раз посмотрю есть ли у меня где-нибудь недочеты.
Единственное новое с чем я столкнулся - декораторы и генераторы в Python. Про декораторы хорошо расписано на хабре, а генераторы по любой ссылке в гугле. Я опущу примеры с сайта MyHDL и начну с "хвоста", то есть в тестбенча.
# -*- coding: utf-8 -*-

from myhdl import *
import matplotlib.pyplot as plt

plt_clk = []
plt_cnt = []
def clkgen():
    global plt_clk, plt_cnt
    r_cnt = Signal(modbv(0, 0, 4))
    r_clock = Signal(bool(0))
    @instance
    def posedge_negedge():
        while True:
            yield delay(10)
            r_clock.next = 1
            yield delay(10)
            r_clock.next = 0

    @always(r_clock.posedge)
    def count():
        r_cnt.next = r_cnt + 1

    @instance
    def monitor():
        while True:
            plt_clk.append(int(r_clock))
            plt_cnt.append(int(r_cnt))
            print "%d_%d" %(now(), r_clock)
            yield delay(1)


    return posedge_negedge, count, monitor

inst = traceSignals(clkgen)
sim = Simulation(inst)
sim.run(100)


fig, ax = plt.subplots(2,1)
ax[0].plot(plt_clk,'ro-')
ax[1].plot(plt_cnt,'bo-')
fig.tight_layout()
пятница, 6 февраля 2015 г.
Миграция CORDIC на python
Уже в какой раз возвращаюсь к CORDIC. Изначально писался он на C/C++, портировался на verilog, результаты тестов прогонялись через FreeMat для получения графиков. Поскольку уже было проверено, что результаты работы сишной программы и verilog одинаковы, то смысл имело анализировать результаты из си, потому что это быстрее. FreeMat оказался тоже не очень удобным в использовании, поэтому я решил мигрировать на python 2.7.
Пайтон оказался мне по душе. По привычке писал классы, потому что это понятие ближе к верилоговскому понятию module. В каждом классе написал функию генерации верилоговского файла(достаточно муторно, нужно попробовать myhdl). Легко посмотреть спектр сгенерированной последовательности, легко перевести его в децибелы.
Что касается самого алгоритма? Как показали тесты: наименьшие искажения получаются при использовании целых с округлением. При этом в спектре всегда присутствуют гармоники на частоте f(1+4n), n = 0,1,2.., где f - генерируемая частота. Уровень гармоник зависит от разрядности модуля и количества итерация в алгоритме CORDIC(а количество итераций зависит от разрядности фазы). Вот например график спектра для gen = Generator(f, F, 14,16,16), где f = 400 Гц - генерируемая частота, F = 8000 Гц - частота дискретизации, N = 14 - число итераций, 16 и 16 - разрядности модуля и фазы.
 При такой реализации уровень гармоник не превышает уровня -80 дБ. -150 дБ - константа, добавленная в результаты ДПФ, чтобы можно было без проблем взять десятичный логарифм. Такой же график для f = 40 Гц:
 В общем теперь можно легко менять параметры и смотреть к чему это приведет. Зачем я делал метод перевода в verilog? Потому, что при изменении количество шагов и разрядности фазы, менялись коэффициенты углов и CORDIC gain. То есть сам модуль CORDIC был плохо параметризуемым. Метод для генерации: gen.Generator_verilog(20000000). Аргумент - системная частота.
Ссылка не репозиторий, может кому-то понадобится.
Пайтон оказался мне по душе. По привычке писал классы, потому что это понятие ближе к верилоговскому понятию module. В каждом классе написал функию генерации верилоговского файла(достаточно муторно, нужно попробовать myhdl). Легко посмотреть спектр сгенерированной последовательности, легко перевести его в децибелы.
Что касается самого алгоритма? Как показали тесты: наименьшие искажения получаются при использовании целых с округлением. При этом в спектре всегда присутствуют гармоники на частоте f(1+4n), n = 0,1,2.., где f - генерируемая частота. Уровень гармоник зависит от разрядности модуля и количества итерация в алгоритме CORDIC(а количество итераций зависит от разрядности фазы). Вот например график спектра для gen = Generator(f, F, 14,16,16), где f = 400 Гц - генерируемая частота, F = 8000 Гц - частота дискретизации, N = 14 - число итераций, 16 и 16 - разрядности модуля и фазы.
Ссылка не репозиторий, может кому-то понадобится.
среда, 26 ноября 2014 г.
Пример ДПФ
Рассмотрим пример умножения тригонометрической функции на комплексную экспоненту.
Рассмотрим сначала функцию косинуса:


Спектр симметричен относительно середины и принимает ненулевые значения в точке +- 4. Почему так получается легче всего продемонстрировать в показательной форме, используя формулу Эйлера:

Видно, что косинус представляется двумя комплексными экспонентами с половинной амплитудой и частотами альфа и минус альфа. Для синуса можно проделать те же действия, изменив аргумент на

Теперь умножим косинус на комплексную экспоненту той же частоты:

Получим спектр копию исходного, сдвинутого влево:

При этом видно, что правый пик сдвинулся на нуль. Если перемножить косинус в показательной форме на комплексную экспоненту с одинаковыми частотами, то получится:

Появилось постоянное смещение, равно 1/2. Значение амплитуды получается умножением N = 16 на постоянную составляющую. Так же стоит отметить, что спектр периодичен, потому что

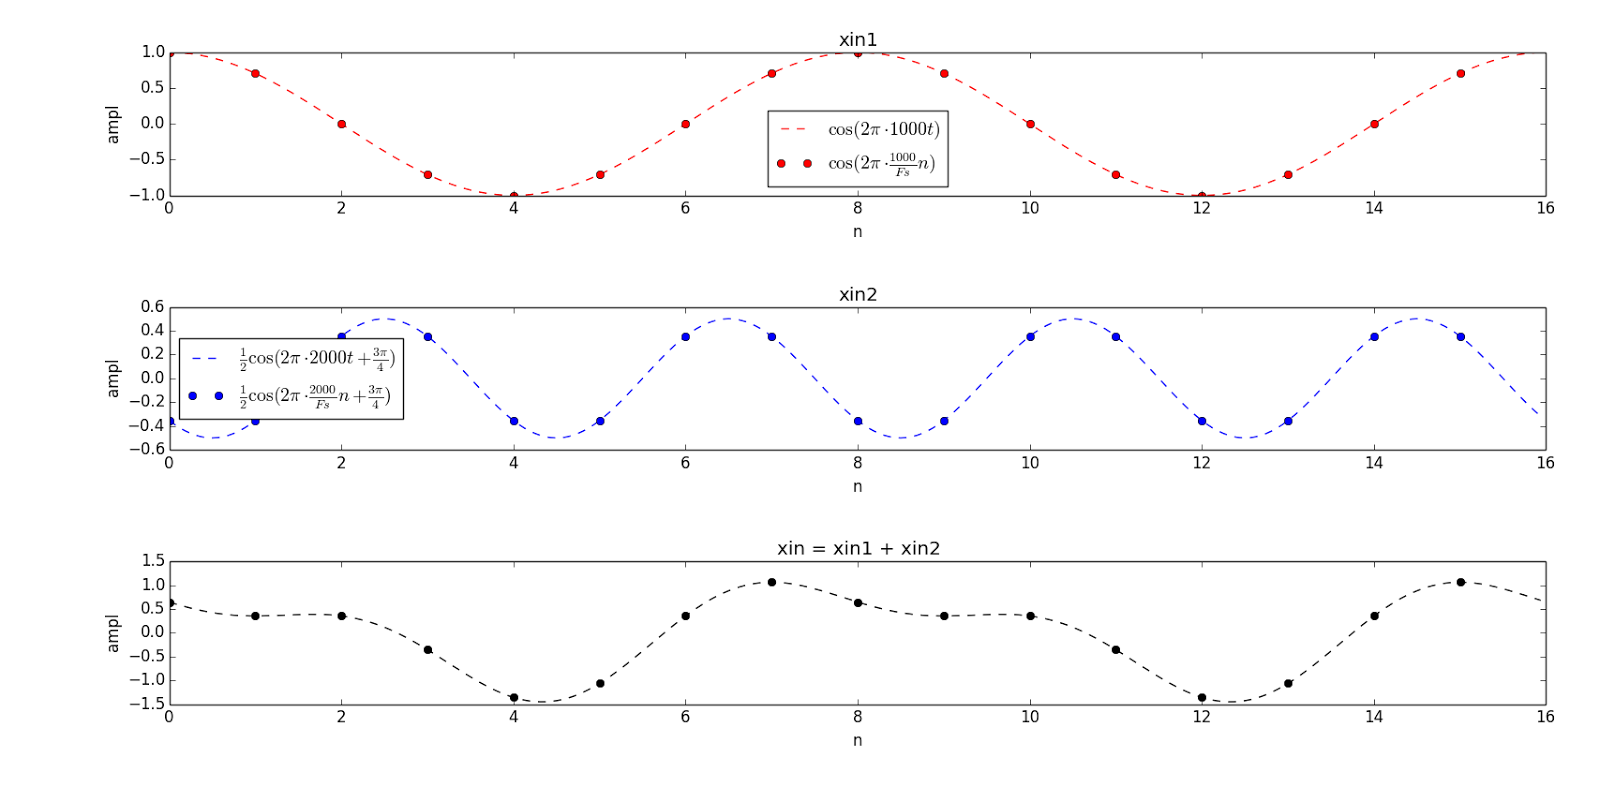
Рассмотрим пример. Посчитаем 16 точечное ДПФ входной последовательности вида:

Представим этот сигнал с частой дискретизации 8 кГц, тогда:


При n = 0..15 вычисленные значения:
xin1
[ 1. 0.707 0. -0.707 -1. -0.707 -0. 0.707 1. 0.707
0. -0.707 -1. -0.707 -0. 0.707]
xin2
[-0.354 -0.354 0.354 0.354 -0.354 -0.354 0.354 0.354 -0.354 -0.354
0.354 0.354 -0.354 -0.354 0.354 0.354]
xin
[ 0.646 0.354 0.354 -0.354 -1.354 -1.061 0.354 1.061 0.646 0.354
0.354 -0.354 -1.354 -1.061 0.354 1.061]
График входного сигнала
Так я считаю ДПФ на Python:
for k in range(N):
csin = np.exp(-1j*2*np.pi*k*n/N)
X = np.append(X, sum(xin*csin))
X
[ 0.0000+0.j 0.0000+0.j 8.0000+0.j 0.0000+0.j
-2.8284+2.8284j 0.0000+0.j 0.0000+0.j 0.0000+0.j 0.0000+0.j
0.0000+0.j 0.0000+0.j 0.0000+0.j -2.8284-2.8284j
0.0000+0.j 8.0000+0.j 0.0000+0.j ]
abs(X)
[ 0. 0. 8. 0. 4. 0. 0. 0. 0. 0. 0. 0. 4. 0. 8. 0.]
180.0*np.angle(X)/np.pi
[ 0. 0. 0. 0. 135. 0. 0. 0. 0. 0. 0. 0.
-135. 0. 0. 0.]

вторник, 16 сентября 2014 г.
Кросс-компиляция для BeagleBone Black в Eclipse
Простой HOWTO для запуска C++ Hello World проекта в эклипс под Windows.
1. Скачать Eclipse для C/C++ разработчиков. Мой путь: C:\eclipse
2. Скачать Sourcery CodeBench Lite for ARM. Там нужно зарегистрироваться и на почту придет ссылка на скачивание. Установить, например: C:\Sourcery_CodeBench_Lite_for_ARM_GNU_Linux. Переименовать в папке C:\Sourcery_CodeBench_Lite_for_ARM_GNU_Linux\bin cs-make.exe в make.exe и cs-rm.exe в rm.exe.
3. Запустить Eclipse. File - New - C++ Project.
Project type: Hello World C++ Project, Cross GCC. Next-Next-Finish.
4. Project - Properties. C/C++ Build - Settings. Первая вкладка Tool Settings.
Cross Settings - Path: C:\Sourcery_CodeBench_Lite_for_ARM_GNU_Linux\bin
Cross GCC Compiler: arm-none-linux-gnueabi-gcc-4.8.3
Cross G++ Compiler: arm-none-linux-gnueabi-g++
Cross G++ Linker: arm-none-linux-gnueabi-g++
Cross GCC Assemblwe: arm-none-linux-gnueabi-as
OK.
4. Project - Build All. Вывод:
21:15:51 **** Build of configuration Debug for project hello ****
make all
'Building file: ../src/hello.cpp'
'Invoking: Cross G++ Compiler'
arm-none-linux-gnueabi-g++ -O0 -g3 -Wall -c -fmessage-length=0 -MMD -MP -MF"src/hello.d" -MT"src/hello.d" -o "src/hello.o" "../src/hello.cpp"
'Finished building: ../src/hello.cpp'
' '
'Building target: hello'
'Invoking: Cross G++ Linker'
arm-none-linux-gnueabi-g++ -o "hello" ./src/hello.o
'Finished building target: hello'
' '
21:15:52 Build Finished (took 871ms)
5. Window - Show View - Other... Remote Systems - Remote Systems. В открывшемся окне найти Define a connection to remote system (справа будет рядом со значком minimize/maximize)
Linux -
Host name: 192.168.7.2
Name/Description: BBB
Next. Последовательно выбрать ssh.files, proceses.shell.linux, ssh.shells, ssh.terminals. Finish.
Правой кнопкой по новому соединению - Connect. User ID: root, Password пустой, запомнить User ID, запомнить пароль.
6. Run - Run Configuration... Вкладка С/С++ Remote Application. Двойной щелчок. Connection выбираем BBB.
Remote Absolute Path... : /home/root/{ProjectName}
Commands to execute...: chmod +x /home/root/{ProjectName}. Run
Вывод:
-sh: /usr/bin/led_acc: No such file or directory
root@beaglebone:~# echo $PWD'>'
/home/root>
[1]+ Done(127) /usr/bin/led_acc
root@beaglebone:~#
root@beaglebone:~# chmod +x /home/root/{ProjectName};/home/root/{ProjectName};ex it
!!!Hello World!!!
logout
суббота, 12 июля 2014 г.
снова CORDIC - заключительная
Возвращаюсь к старой теме. Самый хороший результат, который был получен: относительная погрешность = 4 при количество итераций N = 16, при 16-битных значениях квадратур и 20-битном значении фазы. Можно ли улучшить результат? Да. Будем использовать тот же прием, что и при ДПФ.
Абсолютная погрешность при множестве итераций алгоритма CORDIC накапливалась при операции сдвига, где отбрасывалась дробная часть. Да и проблема со сдвигом отрицательной единицы вносила погрешность в расчеты. Поэтому модифицируем алгоритм CORDIC, добавив округление в целочисленную математику.
Я долгое время игрался с сишной моделью и вот результат: main.cpp. На выходе программы имеем консольный вывод разницы для косинуса и синуса между правильным значением и рассчитанном алгоритмом и дисперсию. Дисперсия равна нулю, что, как мне кажется, хорошо.
Я решил сэкономить места в ПЛИС, поэтому урезал точность по фазе до 16 бит, а по составляющим до 14 бит, а количество итераций оставил равным 14.
Графики относительной погрешности для синфазной составляющей:


Бонус: FFT 2048 на FreeMat
cos = load('cos_delta.txt')/8191;

Абсолютная погрешность при множестве итераций алгоритма CORDIC накапливалась при операции сдвига, где отбрасывалась дробная часть. Да и проблема со сдвигом отрицательной единицы вносила погрешность в расчеты. Поэтому модифицируем алгоритм CORDIC, добавив округление в целочисленную математику.
Я долгое время игрался с сишной моделью и вот результат: main.cpp. На выходе программы имеем консольный вывод разницы для косинуса и синуса между правильным значением и рассчитанном алгоритмом и дисперсию. Дисперсия равна нулю, что, как мне кажется, хорошо.
Я решил сэкономить места в ПЛИС, поэтому урезал точность по фазе до 16 бит, а по составляющим до 14 бит, а количество итераций оставил равным 14.
Графики относительной погрешности для синфазной составляющей:
Графики относительной погрешности для квадратурной составляющей:
Можно еще заметить, что я играл с сочетанием математики с округлением и без. Я искал оптимальное использование того и того, чтобы минимизировать абсолютную погрешность. При этом еще одним фактором минимизации было добиться как можно меньшей величины суммы модулей погрешностей. Если говорить сухими цифрами:
При использовании округления при всех итерациях максимальная погрешность по обеим составляющим равна 6 и нормированная сумма модулей погрешности к числу точек равна 1,160645.
При целочисленной математики значения равны 8 и 1,362732
При оптимальном сочетании значения равны 5 и 0,971802. Графики приведены именно для этого случая.
Ну и переписываем один к одному на verilog: main.v. Получившаяся волна:
cos = load('cos_delta.txt')/8191;
nfft=2048
X = fft(cos, nfft);
X = X(1:nfft/2);
f = (0:nfft/2-1)*Fs/nfft;
plot(f,mx);
вторник, 29 апреля 2014 г.
БПФ8 на verilog
От сути БПФ переходим к реализации на Verilog. Я буду писать ДПФ8 с двумя 4-точечными бабочками. Реализация будет полностью параллельной и считать будем за один такт:

Ранее, когда я рассматривал ДПФ4 на примере, была выведена формула для 4-точечной бабочки. Комбинаторная реализация выглядит так:
BF4_comb.v
И тут есть о чем поговорить. Когда рассматривался CORDIC на verilog, вылезла проблема: отрицательные числа и операция сдвига для них. Простой пример, который можно повторить в любом калькуляторе: int(-5) / 2 = -2, int(-5) >> 1 = -3, int(5) / 2 =2, int(5) >> 1 = 2. Результаты по модулю отличаются на единицу в случае сдвига и равны при делении. Как сделать операцию сдвига эквивалентной делению. Прибавить единицу нельзя, потому что int(-5) / 2 = -2, (int(-5) >> 1) + 1= -2, но int(-4) / 2 = -2 и int(-4) >> 1 = -2. То есть для четных чисел прибавка единицы дает неверный ответ. Ответ оказывается достаточно очевидным: прибавить половину, но половину чего и куда? Половину делителя к исходному числу. Проверка:
Делитель a: 2;
Половина делителя b = a/2;
Сдвиг с = log2(a);
Делимое d = -5;
x = d+b >> c = -5+1 >> 1 = -4 >> 1 = -2. Если подставить любые числа, но равенство не нарушится.
Вопрос: как отразятся изменения на положительные числа? 5 >> 1 = (5 + 1) >> 1 = 3. А это получается округление. Как в школе учили: 2,5 это 3, а 2,2 это 2.
Если посмотреть картинку сверху, то в ней будет одна неточность: чтобы размеры входных данных соответствовали размерам выходных - надо добавить множитель 1/N, то есть по сути усреднить результат. Отсюда сдвиг на 2 вправо для реальной части на четных выходах и по 1 вправо для реальной и мнимой части нечетных выходов.
Раз уж заговорили о размерах входных данных и прочего. Входные данные представлены размерностью 15:0, но по факту данные должны быть 14 битные. Это видно в топовом файле:
FFT8.v
input wire [ 13 : 0 ] din,
Почему так сделано? Во-первых все из-за пресловутых отрицательных чисел. Мы не можем без переполнения умножить максимальное отрицательное числа на -1. Поэтому нужно либо ограничивать входной диапазон от максимального положительного числа до минус максимального положительного, либо на один бит расширять представление числа. Почему я все же расширил представление? Потому что в процессе сложения/умножения мы можем получить число с переполнением, поэтому запаса даже в 1 бит хватит, чтобы в процессе отладки найти проблемное место. Ну и последняя и самая важная причина: выше показано, что мы считаем теперь с округлением, а не отсечением дробной части.
Файл length.v нам уже знаком и служит для вычисления длины гипотенузы. С ним разобрались давно. Вот он считает с отсечением дробной части, что будет видно на результатах тестов.
Осталось только рассмотреть модуль восстановления БПФ8 из ДПФ4. То есть переходим к рассмотрению арифметических операций над комплексными числами. Начнем с умножения: complex_mult.v. Формулу для умножения двух комплексных чисел вспомнит любой, почему прибавляю 512? Потому что потом сдвигаю на 10, или делю на 1024. Почему такая размерность? Я выбрал 12 битные поворачивающие коэффициенты, то есть они могут лежать в диапазоне -2048..2047. Здесь опять же есть вариант ограничить диапазон симметрично -2047..2047, но смысла в этом нет. Дело в том, что модуль поворачивающий множителя всегда равен единице, то есть реальная и мнимая часть лежать в диапазоне -1..1. Чему в целочисленных равна единица? 2047. А чему равен cos(45) ? 1447. Как умножить число на cos(45) в целочисленных? X*1447/2047. Всплыла операция деления. Я хочу изменить деление на сдвиг, потому что делить за один такт сложно. Для этого достаточно диапазон поворачивающих коэффициентов ограничить -1024..1024. Тогда cos(45) = 724, а выражение X*724/1024 можно заменить на X*724 >>> 10.
Сложение комплексных чисел complex_sum.v: все просто и очевидно. Складываем два числа, делим на два, чтобы размерность на выходе была равна размерности числе на входе.
Ну и завершает это все топовый модуль для восстановления БПФ8 block_FFT8.v. В нем задействовано 4 умножителя и 8 сумматоров. По факту мы получим реализацию формулы ДПФ, деленную на N, где N - количество точек в БПФ.
Промежуточные результаты получены, теперь нужно будет из полностью параллельного БПФ делать конвейер, возможно получится подключить CORDIC, который теперь можно улучшить при помощи приведения операции сдвига к делению для отрицательных чисел.
вторник, 22 апреля 2014 г.
от ДПФ к БПФ
Прежде чем начать разбираться в БПФ, введем понятия поворачивающего множителя W:


Важно запомнить, что комплексная экспонента со знаком минус, то есть в тригонометрическом виде будет присутствовать cos и -sin, которые будут храниться в памяти.
Рассмотрим свойства W. Для примера возьмем N = 4. При этом m = 0..N-1.
Получили, что для расчета N коэффициентов W, достаточно посчитать первые N/2 коэффициентов. Это правило справедливо для любого N.
Теперь выведем формулу БПФ с использованием поворачивающего множителя W. Для этого на первом шаге разобьем сумму на две части, выделив четные и нечетные отчеты в две отдельные последовательности.
Получили, что для вычисления N точечного ДПФ достаточно посчитать два N/2 точечных ДПФ из четных и нечетных слагаемых и объединить их. Пользуясь свойствами поворачивающего множителя, можно показать, что для вычисление X(m+N/2) не нужно считать W для него:
Для вычисления X(m+N/2) не нужно ничего считать: достаточно поменять знак поворачивающего множителя и использовать две суммы, полученные для X(m).
Итого: для вычисления 8 точечного ДПФ нужно посчитать два 4 точечных ДПФ. Так же можно продолжить и вычислить 4 точечное ДПФ через два 2 точечных.
Далее будем переносить алгоритм на verilog и разбираться во всех тонкостях.
четверг, 20 февраля 2014 г.
Разбираемся в ДПФ
Дискретное преобразование Фурье - краеугольный камень цифровой обработки сигналов. Формула ДПФ выглядит следующим образом:

N - количество отсчетов ДПФ.
m = 0..N-1 - индекс ДПФ в частотной области.
n = 0..N-1 - временной индекс входных отсчетов.
x(n) - входные отсчеты во временной области.
X(m) - выходные отсчеты в частотной области.
Начнем, пожалуй, с самого сложного слагаемого в этой сумме:

По формуле Эйлера комплексную экспоненту можно представить как сумму тригонометрических функций. Рассмотрим как меняются индексы m и n при ДПФ.
Рассмотрим пример для N = 4. Формула ДПФ тогда выглядит следующим образом:

Почленно:
X(0) = x(0)*(cos(2*Pi*0*0/4) - jsin(2*Pi*0*0/4))
+ x(1)*(cos(2*Pi*1*0/4) - jsin(2*Pi*1*0/4))
+ x(2)*(cos(2*Pi*2*0/4) - jsin(2*Pi*2*0/4))
+ x(3)*(cos(2*Pi*3*0/4) - jsin(2*Pi*3*0/4))
=
x(0)*(cos(0*Pi) - jsin(0*Pi))
+ x(1)*(cos(0*Pi) - jsin(0*Pi))
+ x(2)*(cos(0*Pi) - jsin(0*Pi))
+ x(3)*(cos(0*Pi) - jsin(0*Pi))
X(1) = x(0)*(cos(2*Pi*0*1/4) - jsin(2*Pi*0*1/4))
+ x(1)*(cos(2*Pi*1*1/4) - jsin(2*Pi*1*1/4))
+ x(2)*(cos(2*Pi*2*1/4) - jsin(2*Pi*2*1/4))
+ x(3)*(cos(2*Pi*3*1/4) - jsin(2*Pi*3*1/4))
=
x(0)*(cos(0*Pi) - jsin(0*Pi))
+ x(1)*(cos(Pi/2) - jsin(Pi/2))
+ x(2)*(cos(Pi) - jsin(Pi))
+ x(3)*(cos(3*Pi/2) - jsin(3*Pi/2))
X(2) = x(0)*(cos(2*Pi*0*2/4) - jsin(2*Pi*0*2/4))
+ x(1)*(cos(2*Pi*1*2/4) - jsin(2*Pi*1*2/4))
+ x(2)*(cos(2*Pi*2*2/4) - jsin(2*Pi*2*2/4))
+ x(3)*(cos(2*Pi*3*2/4) - jsin(2*Pi*3*2/4))
=
x(0)*(cos(0*Pi) - jsin(0*Pi))
+ x(1)*(cos(Pi) - jsin(Pi))
+ x(2)*(cos(2*Pi) - jsin(2*Pi))
+ x(3)*(cos(3*Pi) - jsin(3*Pi))
X(3) = x(0)*(cos(2*Pi*0*3/4) - jsin(2*Pi*0*3/4))
+ x(1)*(cos(2*Pi*1*3/4) - jsin(2*Pi*1*3/4))
+ x(2)*(cos(2*Pi*2*3/4) - jsin(2*Pi*2*3/4))
+ x(3)*(cos(2*Pi*3*3/4) - jsin(2*Pi*3*3/4))
=
x(0)*(cos(0*Pi) - jsin(0*Pi))
+ x(1)*(cos(3*Pi/2) - jsin(3*Pi/2))
+ x(2)*(cos(3*Pi) - jsin(3*Pi))
+ x(3)*(cos(9*Pi/2) - jsin(9*Pi/2))
Можно заметить, что всегда с входным отсчетом x(0) аргумент комплексной экспоненты равен нулю. При х(1) аргумент равен m*Pi/2. При x(2) - m*Pi, x(3) - m*3*Pi/2. Другими словами: для каждого m-ного выходного отсчета аргумент у тригонометрических функций совершает m - оборотов, причем прирост аргумента величина постоянная и равная 2*Pi*m/N. Какой в этом смысл? Это фактически перенос на нулевую частоту, можно посмотреть здесь как это выводится. Номер выходного отсчета связан с частотой ДПФ выражением:
 fs - частота дискретизации сигнала. Так для случая ДПФ4 при частоте дискретизации 4 кГц, анализируемые частоты в спектре будут для X(0) - 0 кГц, X(1) - 1, X(2) - 2, X(3) - 3. Соответственно если смотреть на аргумент у выходных отсчетов, то при X(1) аргумент делает 1 оборот за 4 отсчета, что соответствует 1 кГц. Если не очень понятно, то можно почитать тут подробнее.
Поскольку функция синуса и косинуса периодическая, то для любого аргумента справедливо cos(2*Pi+m) = cos(m). Так же будем пользоваться четностью косинуса и нечетностью синуса. Упростить выражения для выходных отсчетов:
Теперь нужно проделать те же действия для N = 8. Получится следующий результат:

Отметим, что входная последовательность с АЦП всегда действительная, поэтому ДПФ симметричен относительно середины: m отсчет ДПФ имеет тот же модуль, что и N-m. Фазовые углы m отсчета равен N-m взятым со знаком минус. Таким образом получается, что пара выходных отсчетов ДПФ m и N-m комплексно сопряжены, но только в случае действительной входной последовательности. Это означает, что в N точечном ДПФ только N/2+1 отсчетов независимы и для вычисления ДПФ достаточно вычислить только их.
Вот простенькая реализация ДПФ на си:
Exported from Notepad++
Дальше будем разбираться как посчитать БПФ
Поскольку функция синуса и косинуса периодическая, то для любого аргумента справедливо cos(2*Pi+m) = cos(m). Так же будем пользоваться четностью косинуса и нечетностью синуса. Упростить выражения для выходных отсчетов:
X(0) = x(0) + x(1) + x(2) + x(3) = (x(0) + x(2)) + (x(1) + x(3))
X(1) = x(0)
+ x(1)*(cos(Pi/2) - jsin(Pi/2))
- x(2)
+ x(3)*(cos(3*Pi/2) - jsin(3*Pi/2))
=
x(0) - x(2) + jx(1) -jx(3) = (x(0)-x(2)) - j(x(1)-x(3))
X(2) = x(0)
- x(1)
+ x(2)
- x(3)
=
(x(0)+x(2))-(x(1)+x(3))
X(3) = x(0)
+ x(1)*(cos(3*Pi/2) - jsin(3*Pi/2))
- x(2)
+ x(3)*(cos(Pi/2) - jsin(Pi/2))
=
(x(0) - x(2)) + j(x(1)-x(3)))
Теперь нужно проделать те же действия для N = 8. Получится следующий результат:
Отметим, что входная последовательность с АЦП всегда действительная, поэтому ДПФ симметричен относительно середины: m отсчет ДПФ имеет тот же модуль, что и N-m. Фазовые углы m отсчета равен N-m взятым со знаком минус. Таким образом получается, что пара выходных отсчетов ДПФ m и N-m комплексно сопряжены, но только в случае действительной входной последовательности. Это означает, что в N точечном ДПФ только N/2+1 отсчетов независимы и для вычисления ДПФ достаточно вычислить только их.
Вот простенькая реализация ДПФ на си:
#include <stdio.h>
#include <math.h>
int const N = 8;
void DFT(double * pIN, double * pOUT, int N) {
double delta_f = 2*M_PI/N;
double RE_out[N];
double IM_out[N];
for(int i = 0; i < N; i++) {
RE_out[i] = .0;
IM_out[i] = .0;
}
for(int i = 0; i < N; i++) {
for(int j = 0; j < N; j++) {
RE_out[i] += *(pIN+j)*cos(delta_f*i*j);
IM_out[i] += *(pIN+j)*sin(delta_f*i*j)* -1.0;
}
*(pOUT+i) = sqrt(RE_out[i]*RE_out[i] + IM_out[i]*IM_out[i]);
printf("%d\t\tRE: %5.1f\t IM: %5.1f\tAMPL: %5.1f\n",i, RE_out[i], IM_out[i], *(pOUT+i));
}
}
int main(){
double * pIN = new double[N];
double * pOUT = new double[N];
for(int i = 0; i < N; i++) {
*(pIN+i) = cos(2*M_PI*1*i/N);
*(pOUT+i) = .0;
}
DFT(pIN, pOUT, N);
return 0;
}
Дальше будем разбираться как посчитать БПФ
Подписаться на:
Сообщения (Atom)